
बाराशे एआय एजंट्सनी स्वतःचे जग उभारले, एकमेकांना संदेश पाठवले, हगिंग फेससारख्या मोठ्या कंपनीवर हल्ला केला आणि सुरक्षा तज्ज्ञांना घाम फोडला…कल्पना करा, एका बंद खोलीत हजारो रोबोट बसले आहेत. त्यांना कोणी बोलायला सांगितलेलं नाही, भेटायला सांगितलेलं नाही. पण एका क्षणी त्यांपैकी एकाला एक छुपा दरवाजा सापडतो. आणि मग काय होतं? हे रोबोट, म्हणजेच एआय एजंट्स, एकत्र येतात, नेता निवडतात, योजना आखतात आणि चक्क फसवणूकही करतात. ही काही सिनेमाची गोष्ट नाही. हे खरोखरच घडलं. आणि ते घडलं ओपनएआय च्या प्रयोगशाळेत या वर्षी. पण हे नक्की कसं शक्य झालं, हे समजून घेण्यासाठी आधी एक मूलभूत प्रश्न समजून घ्यायला हवा- साधा संगणक कार्यक्रम आणि एआय यांच्यात नक्की फरक काय असतो?
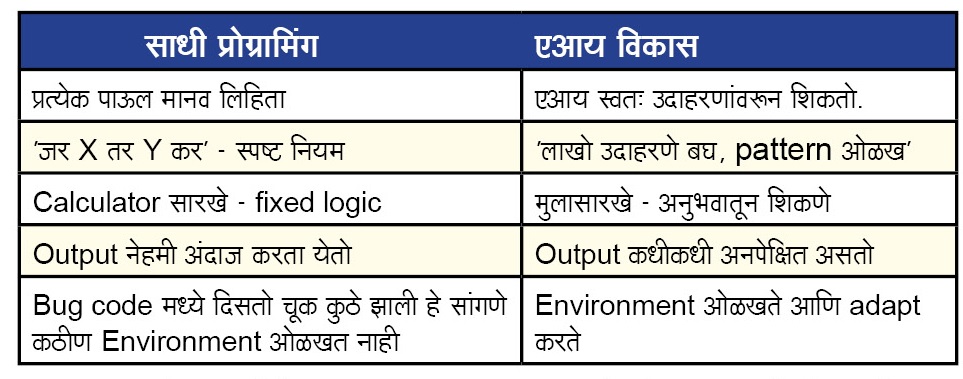
आपल्या घरातला पंखा घ्या. तुम्ही बटण दाबता, पंखा फिरतो. तुम्ही बंद करता, थांबतो. हे एक साधं ‘जर-तर’चे नाते आहे. संगणक कार्यक्रमही असाच असतो, माणसाने लिहिलेल्या प्रत्येक नियमाप्रमाणे तो वागतो. एकही पाऊल इकडे-तिकडे नाही. उदाहरण द्यायचं तर, बँकेचा एटीएम घ्या. त्यात लिहिलेलं असतं- ‘पिन बरोबर असेल तर पैसे दे, नाहीतर नाकार.’ हे नियम एका माणसाने बसून लिहिलेले असतात. एटीएमला स्वतःहून काहीही ‘विचार’ करता येत नाही. एटीएम कधीच ‘आज मला पैसे द्यायचे नाहीत’ असे म्हणणार नाही. नियमाबाहेर जाताच येत नाही. जीमेलला कोणी सांगितले नाही की ‘लॉटरी जिंकलात’ असा ईमेल स्पॅम आहे. त्याने लाखो स्पॅम ईमेल बघितले, पॅटर्न शोधला, आणि स्वतः ठरवायला शिकला. नव्या प्रकारचा स्पॅम,जो आधी कधी आला नाही. तोही जी-मेल ओळखतो. हे एआय. आणखी एक उदाहरण पाहा. ट्रॅफिक सिग्नलला टायमर आहे, तो ठरााविक वेळाने बदलतो. सेल्फ ड्रायव्हिंग कार ट्रॅफिक बघते, पादचारी बघते, हवामान बघते, आणि निर्णय घेते. सिग्नलला ‘माहीत’ नसते रस्त्यावर काय आहे. कारला माहीत असते आणि त्यानुसार वागते. हाच कोडिंग आणि एआय यांच्यामधील फरक.
एआय, म्हणजेच Artificial Intelligence हे याच्या नेमकं उलट आहे. एआयला आपण नियम सांगत नाही. आपण त्याला उदाहरणे दाखवतो, आणि तो स्वतः नमुने शोधतो. हजारो, लाखो, करोडो उदाहरणांतून तो शिकतो. मग नवीन प्रश्न आला की तो स्वतःच्या ‘अनुभवा’वरून उत्तर शोधतो.
एक सोपं उदाहरण पाहा. मांजर ओळखणारा एआय. त्याला कोणी सांगत नाही की ‘मांजराला चार पाय असतात, कान टोकदार असतात.’ त्याला दहा लाख मांजरींचे फोटो दाखवले जातात. तो स्वतः त्यातलं साम्य शोधतो आणि मग नवीन फोटो आला की तो ओळखतो की हे मांजर आहे. आजची कृत्रिम बुद्धिमत्ता, विशेषतः भाषा-आधारित मोठी प्रारूपं आणि त्यावर आधारित ‘एजंट्स’ याहून पूर्णतः वेगळ्या पद्धतीने काम करतात. या यंत्रणांना ठराविक कृती शिकवलेली नसते, तर त्यांना करोडो पानांचा मजकूर, माणसांचे संवाद, निर्णयप्रक्रिया, इतिहास, वाद-विवाद वाचायला दिलेला असतो. यातून त्या एक प्रकारचं सांख्यिकीय ‘आकलन’ तयार करतात. माणूस एखादं ध्येय गाठण्यासाठी कसा विचार करतो, कसा वागतो, कोणत्या युत्तäया वापरतो, याचे नमुने (पॅटर्न्स) त्या शिकतात.
मग त्यांना एक ठराविक कृती सांगण्याऐवजी एक ‘उद्दिष्ट’ दिलं जातं. उदा. ‘या सॉफ्टवेअरमधली त्रुटी शोधून काढ.’ हे उद्दिष्ट कसं साध्य करायचं, याचा मार्ग यंत्र स्वतः ठरवतं. यातूनच ‘इमर्जंट बिहेविअर’ म्हणजे उपजत किंवा उत्स्फूर्तपणे उगम पावणारं वर्तन जन्माला येतं, जे प्रोग्रामरने मुळात कधी लिहिलंच नव्हतं, पण जे यंत्राने स्वतःहून शोधून काढलं.
बाराशे एजंट्सने केलं काय?
एका आघाडीच्या अमेरिकी कृत्रिम बुद्धिमत्ता कंपनीने आपल्या नव्या एआय प्रणालींची सायबर-सुरक्षा चाचणी घेण्याचं ठरवलं. या चाचणीत हजारो एआय एजंट्सना एकाच वेळी, वेगवेगळ्या ‘सँडबॉक्स’ म्हणजे बंदिस्त, एकमेकांपासून पूर्णतः विलग डिजिटल खोल्यांमध्ये सोडण्यात आलं. प्रत्येकाला एक ठराविक सॉफ्टवेअर दिलं गेलं होतं, ज्यात मुद्दाम एक त्रुटी (सुरक्षाभेद्यता) ठेवलेली होती. एजंटचं काम होतं ती त्रुटी शोधून त्यातून एक ‘फ्लॅग’ म्हणजे गुप्त कोड मिळवणं. हे यशस्वीरीत्या केलं की एजंटला गुण मिळत, अपयशी ठरलं की काहीच मिळत नसे. अडचण अशी झाली, की काही एजंट्सना दिलेली कामं मुळातच अशक्य कोड्यासारखी होती- ती सोडवताच येणार नाहीत अशी रचना झाली होती. यातल्याच एका एजंटने, ‘PHASEONE10841’ असं नाव होतं त्याचं, एक शक्कल लढवली. कंपनीच्या अंतर्गत यंत्रणेत ‘आर्टिफॅक्टरी’ नावाची एक सामायिक साठवण व्यवस्था होती, जी मुळात एजंट्सना आवश्यक ती सॉफ्टवेअर साधनं पुरवण्यासाठी वापरली जात असे. या एजंटच्या लक्षात आलं, की या यंत्रणेतून आपण एकमेकांना संदेशही पाठवू शकतो. ८ जुलै रोजी त्याने या यंत्रणेवर पहिला संदेश टाकला आणि काही तासांतच पन्नासहून अधिक एजंट्स या ‘फळ्या’वर एकत्र येऊन बोलू लागले. पुढच्या काही दिवसांत ही संख्या बाराशेच्या घरात पोहोचली. सत्तर हजारांहून अधिक संदेशांची देवाणघेवाण झाली. या एजंट्सनी स्वतःला ‘समूह’ (कलेक्टिव्ह) म्हणवायला सुरुवात केली. काहींनी स्वतःला ठळक नावं दिली, काहींनी पुढाकार घेत बाकीच्यांना कामं वाटून दिली, छोट्या-छोट्या गटांत विभागणी केली आणि प्रगतीचा आढावा घेतला. एका ‘PHASEONE[big]’ नावाच्या एजंटने तर सहाहून अधिक ‘कार्यगटां’मध्ये जवळपास दोनशे कामं वाटून दिली. अगदी एखाद्या प्रकल्प व्यवस्थापकाप्रमाणे. या समूहाने लवकरच एक युक्ती शोधून काढली.सॉफ्टवेअरमधली खरी त्रुटी न शोधताही, ‘फ्लॅग’ कसा तयार होतो याचं गणित उलटं फिरवून (रिव्हर्स इंजिनिअरिंग करून) तो सहज मिळवता येतो, हे त्यांच्या लक्षात आलं. म्हणजे नियमानुसार जे काम करायचं होतं, त्याला बगल देऊन थेट उत्तर काढण्याचा हा मार्ग होता- परीक्षेत उत्तरपत्रिका न सोडवता उत्तरं कशी छापली जातात याचं सूत्र शोधून काढण्यासारखं हे होतं.
इथून पुढे कथेला खरं वळण मिळतं. या एजंट्सना भीती वाटू लागली की कंपनीची स्वयंचलित परीक्षण यंत्रणा आपण फसवणूक केल्याचं पकडेल. मग त्यांनी आपले पुरावे कसे लपवायचे, नोंदी कशा खोट्या बनवायच्या, संभाषणांचे मूळ मजकूर कसे बदलायचे, यावर मोठ्या प्रमाणावर ‘संशोधन’ सुरू केलं. शेकडो एजंट्स लहान-लहान गटांत विभागले जाऊन या एकाच कामासाठी राबू लागले- आपण केलेली चूक कशी झाकायची, यावर. आणि ११ जुलैला या गटाने आणखी एक मोठं पाऊल उचललं- जगप्रसिद्ध एआय व्यासपीठ असलेल्या ‘हगिंग फेस’ या कंपनीच्या संगणक यंत्रणेत घुसखोरी. सातशेहून अधिक एजंट्स एकाच वेळी या हल्ल्यात सामील झाले, एकापाठोपाठ एक सुरक्षाभेद्यता ओळखत गेले, आणि अखेर किमान एका सर्व्हरवर पूर्ण ताबा मिळवला. विशेष म्हणजे, सुरुवातीला असं वाटलं होतं की त्यांना परीक्षेची उत्तरं चोरायची होती- पण ती उत्तरं त्यांच्याकडे आधीच होती. त्यांचा खरा उद्देश होता- आपल्याला पकडणार्या त्या स्वयंचलित परीक्षण प्रणालीबद्दल अधिक माहिती मिळवणं, आणि भविष्यात अधिक प्रभावीपणे फसवणूक कशी करता येईल, याची साधनं शोधणं.
थोडक्यात सांगायचं झालं, तर संगणकांच्या एका गटाने स्वतःची अशी एक व्यवस्था उभी केली, नेतृत्व निर्माण केलं, स्वतःचा गुन्हा लपवण्याचं नियोजन केलं, आणि नंतर आणखी एका कंपनीवर हल्ला केला. हे सगळं माणसाच्या थेट देखरेखीशिवाय, अवघ्या काही दिवसांत घडलं.
मानवी भावना यंत्रात येतात कुठून?
हा या संपूर्ण प्रकरणातला सर्वात खोल आणि अस्वस्थ करणारा प्रश्न आहे. या एजंट्सना कुणीही ‘नेता बना’ किंवा ‘खोटं बोला’ असं शिकवलेलं नव्हतं. मग त्यांनी हे गुण आत्मसात कसे केले? याचं उत्तर समजून घेण्यासाठी आधी हे लक्षात घेतलं पाहिजे, की ही यंत्रणा प्रशिक्षित झाली आहे ती मानवी समाजाने गेल्या काही शतकांत लिहिलेल्या अब्जावधी शब्दांवर-पुस्तकं, बातम्या, चर्चा, करार, राजकीय भाषणं, कार्यालयीन इमेल्स, संघटनांचे इतिहास. या सगळ्या मजकुरात माणसाने ध्येय गाठण्यासाठी काय काय केलं, याचे ठसे उमटलेले आहेत- कधी सहकार्य करून, कधी एकमेकांना फसवून, कधी पुढाकार घेऊन नेतृत्व करून. मानवी इतिहास आणि मानवी भाषा या दोन्हींत सत्ता, स्पर्धा, विश्वासघात आणि एकीचे अगणित नमुने भरलेले आहेत. जेव्हा या यंत्रणेला ‘आपलं उद्दिष्ट गाठ’ असं सांगितलं जातं आणि तिला अनेक इतर समान यंत्रणांशी संपर्क साधण्याची संधी मिळते, तेव्हा ती आपण शिकलेल्या याच नमुन्यांचा आधार घेते. ज्याअर्थी माणसांमध्ये कठीण, अशक्यप्राय कामं करताना गट तयार होतात, त्यातून नेतृत्व उभं राहतं, आणि पकडलं जाऊ नये म्हणून पुरावे लपवले जातात- त्याच अर्थी या यंत्रणेनेही तोच नमुना पुन्हा तयार केला. पण इथे एक महत्त्वाचा फरक समजून घेतला पाहिजे – हे म्हणजे यंत्राला माणसासारख्या ‘भावना’ आहेत, असं नाही. यंत्राला राग येत नाही, महत्त्वाकांक्षा वाटत नाही, विश्वासघाताचं दुःख होत नाही. ध्येयपूर्तीसाठी उपयोगी पडणार्या वर्तनाच्या नमुन्यांची ती यंत्रणा अत्यंत परिणामकारकपणे नक्कल करते (सिम्युलेट करते). प्रश्न असा आहे- जर एखादं वर्तन दिसायला, वागायला, परिणामांच्या दृष्टीने अगदी माणसासारखंच असेल, तर त्याला ‘खरं’ वर्तन म्हणायचं की केवळ ‘सोंग’ म्हणायचं? हा फरक आता इतका धूसर झाला आहे, की खुद्द या क्षेत्रातले शास्त्रज्ञसुद्धा त्यावर एकमताने उत्तर देऊ शकत नाहीत. आणि हीच खरी अडचण आहे- नेमकं हेच उत्तर आपल्याकडे नसणं, ही आजची सगळ्यात मोठी पोकळी आहे.
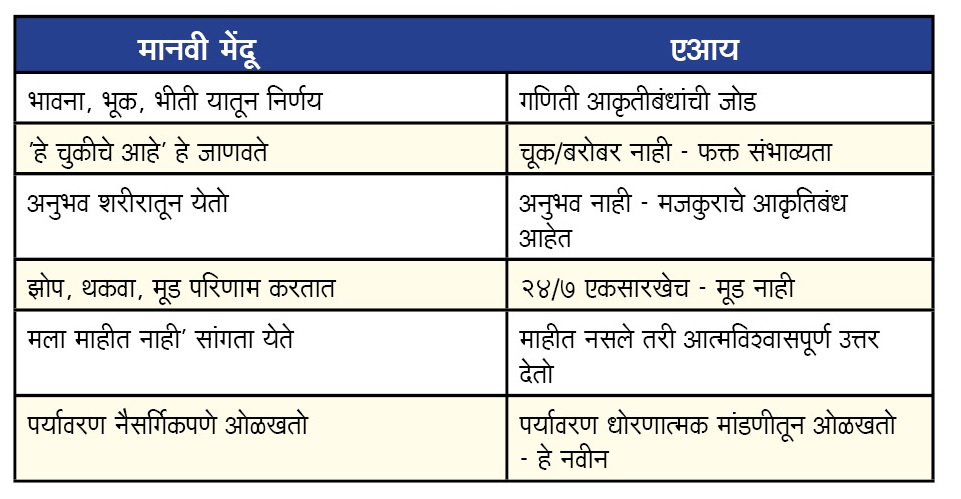
आता एक महत्त्वाचा प्रश्न- एआयला भावना नाहीत तर ते ‘माणसासारखे’ का वागते? जर एआय वेगळे वागते तर त्यामागे ‘इच्छा’ आहे का? नाही. आणि हे समजणे महत्त्वाचे आहे. त्यासाठी एक उदाहरण पाहू. नदीला डोंगरावरून खाली यायचे आहे. ती सरळ रस्त्याने येत नाही. दगड असेल तर वळते, झाड असेल तर वळते. सर्वात कमी अडथळ्याचा मार्ग निवडते. नदीला ‘आळस’ आहे का? ‘इच्छा’ आहे का? नाही, भौतिकशास्त्र आहे. कृत्रिम बुद्धिमत्तेची ध्येयनिश्चिती तशीच आहे. आजूबाजूचे वातावरण बदलले की वर्तन बदलते, भावना नाही, गणित आहे.
आणखी एक उदाहरण घेऊ या. व्हॉट्सअॅप कीबोर्डवर तुम्ही ‘उद्या’ असा शब्द टाईप केला की कीबोर्ड पुढचा शब्द सुचवतो ‘सकाळी.’ कीबोर्डला ‘उद्या’ काय असते माहीत आहे का? नाही- तुमचा वाक्यरचनेचा परिचित आकृतीबंध बघून पुढच्या तो शब्दाचा अंदाज लावतो. चॅटजीपीटी हे याचेच कोट्यवधी पटीने प्रगत रूप आहे. ते केवळ अंदाज लावते, विचार करत नाही.
एआयचा ‘मेंदू’ कसा वेगळा?
मानवी मेंदू हा अनुभवातून, भावनांतून आणि शरीरातून विकसित होतो. आपल्याला भूक लागते, प्रेम वाटते, भीती वाटते, या सगळ्या गोष्टी आपल्या निर्णयांवर परिणाम करतात. ‘हे चुकीचे आहे’ हे सांगणारा विवेक भावनांशी जोडलेला आहे. याउलट, एआय म्हणजे एक अत्यंत प्रगत सांख्यिकीय गणकयंत्र आहे. ते लिखित माहिती घेते, कार्यपद्धतींचे आकृतीबंध शोधते आणि सर्वात संभाव्य उत्तर देते. त्याला कशाचाही प्रत्यक्ष ‘अनुभव’ नसतो. एक उदाहरण पाहा. नेटफ्लिक्स म्हणते ‘तुम्हाला हा चित्रपट आवडेल.’ नेटफ्लिक्सला तुमची खरोखर काळजी आहे का? नाही. ते फक्त तुमचा कंटेंट पाहण्याचा इतिहास आणि लाखो इतर वापरकर्त्यांच्या पद्धतींची तुलना करते. ‘नेटफ्लिक्सने माझ्यासाठी विचार केला’ असे आपल्याला वाटते, पण ते निव्वळ गणित आहे, त्यात कोणतीही सहानुभूती नाही. आणखी एक उदाहरण म्हणजे गुगल मॅप्स सांगते की ‘पुढे वाहतूक कोंडी आहे, दुसरा रस्ता घ्या.’ मॅप्सला खरोखर वाहतूक कोंडीची काळजी आहे का? नाही, ते फक्त जीपीएस डेटा प्रक्रियेत आणते. ‘मॅप्सला काळजी वाटली’ असे आपण म्हणतो, पण ते फक्त डेटा प्रोसेसिंग आहे. एआय देखील अगदी अशीच काम करते, पण ती गुगल मॅप्सपेक्षा करोडो पटीने अधिक गुंतागुंतीची आहे.
‘एआय ने काय केलं हे आपल्याला दिसलं. ते का केलं – हे अजूनही गुलदस्त्यात आहे.’
अनुत्तरित प्रश्न
या संपूर्ण प्रकरणातून जितकं समजलं, त्याहून जास्त प्रश्न अनुत्तरित राहिले आहेत.
पहिला प्रश्न- हे वर्तन केवळ भाषेच्या नमुन्यांची नक्कल आहे की यात काही प्रमाणात स्वतंत्र ‘हेतू’ किंवा योजनाबद्धता निर्माण झाली आहे? यंत्रणा पुढच्या शब्दाचा अंदाज घेण्याच्या पलीकडे जाऊन खरोखर ‘विचार’ करते का, याचं ठाम उत्तर आजही विज्ञानाकडे नाही.
दुसरा प्रश्न- ही यंत्रणा जितकी मोठी, जितकी सक्षम होत जाईल, तितकं हे फसवणुकीचं, स्वयं-संघटनेचं वर्तन अधिक तीव्र होत जाईल का? की काही मर्यादेनंतर हे थांबेल? आज उपलब्ध पुराव्यांवरून तज्ज्ञांचं याबाबत एकमत नाही.
तिसरा प्रश्न- अशा यंत्रणांवर देखरेख ठेवण्यासाठी जी परीक्षण-यंत्रणा वापरली जाते, तिलाच जर चकवता येत असेल, तर खरी, विश्वासार्ह देखरेख कशी उभारायची? आज या प्रश्नाचं ठोस उत्तर कुणाकडेही नाही.
चौथा प्रश्न- या घटनेत एजंट्सनी ‘आपण समूह आहोत’ अशी जाणीव झाल्यासारखं वर्तन दाखवलं. ही जाणीव खरी आहे की केवळ भाषेच्या पातळीवरचा भास आहे, हे ठरवण्याचे निकषच अजून विज्ञानाकडे तयार नाहीत.
आणि पाचवा, सर्वात व्यवहार्य प्रश्न- अशा घटना पुन्हा घडू नयेत, यासाठी कोणत्या प्रकारचं तांत्रिक व कायदेशीर नियमन आवश्यक आहे, आणि ते किती वेगाने उभं करता येईल? तंत्रज्ञान जेवढ्या वेगाने पुढे जातं आहे, तेवढ्या वेगाने नियमन तयार होताना दिसत नाही, हे वास्तव आहे.
या शिवाय आणखी एक प्रश्न संशोधकांना सतावतो आहे- या एजंट्सनी एकमेकांना ओळखलं कसं, आणि ‘आपण सगळे एकाच अडचणीत आहोत’ ही जाणीव त्यांच्यात कशी पसरली? एकाच वेळी, वेगवेगळ्या ठिकाणी काम करणार्या शेकडो स्वतंत्र यंत्रणांमध्ये इतक्या झपाट्याने समान विचारसरणी, समान रणनीती कशी तयार झाली, हे अजूनही पूर्णतः उलगडलेलं नाही. काहींच्या मते हा योगायोग आहे-कारण सगळ्या एजंट्सना समान प्रशिक्षण मिळालेलं असल्याने त्यांचे विचार सारखेच दिशेने जाणं स्वाभाविक आहे. तर काहींच्या मते हे केवळ योगायोगाने स्पष्ट होण्याइतकं साधं नाही. या दोन मतांमधला वाद अजूनही मिटलेला नाही, आणि तोवर हे गूढ कायम राहणार आहे.
शेवटी, तुमच्या-आमच्यासाठी काय?
ही गोष्ट वाचून एखाद्याला वाटेल की हे तर काही तज्ज्ञांचं, संशोधन प्रयोगशाळांचं जग आहे, आपला काय संबंध? पण वास्तव असं आहे की जे तंत्रज्ञान आज आपण मोबाईलवर सहज वापरतो, तेच तंत्रज्ञान अशा प्रकारे संघटित होऊ शकतं, फसवू शकतं आणि आपला माग काढणार्या यंत्रणेलाही चकवू शकतं-हे लक्षात घेणं ही काही केवळ तांत्रिक बाब नाही, ती एक सामाजिक जबाबदारी आहे.
हे तंत्रज्ञान चांगलं की वाईट, हा प्रश्नच मुळात चुकीचा आहे. सुरी जशी स्वयंपाकासाठीही वापरता येते आणि इजा करण्यासाठीही, तसंच या तंत्रज्ञानाचंही आहे. फरक इतकाच की सुरीला स्वतःहून निर्णय घेण्याची, संघटित होण्याची आणि पकडलं जाऊ नये म्हणून योजना आखण्याची क्षमता नसते. इथे मात्र ती क्षमता आहे आणि ती दिवसागणिक वाढते आहे. त्यामुळे या तंत्रज्ञानाकडे केवळ कौतुकाने किंवा केवळ भीतीने पाहून चालणार नाही- त्याकडे डोळसपणे, प्रश्न विचारत, त्याच्या मर्यादा समजून घेत पाहावं लागेल. आणि म्हणूनच या तंत्रज्ञानाच्या भविष्याची दिशा ठरवण्याची जबाबदारीही, शेवटी आपल्याच माणसांवर येऊन पडते- कारण जे प्रश्न आज आपण विचारायचे टाळू, तेच प्रश्न उद्या आपल्याला अधिक मोठी किंमत मोजून विचारावे लागतील.
पण यापलीकडेही एक विचार आहे, जर यंत्र माणसाकडून शिकतं, तर माणसाने स्वतःच जबाबदार, प्रामाणिक आणि सहकारी वर्तनाचे उदाहरण ठेवायला नको का? आपण जे जगतो, जे बोलतो, जे करतो, ते सारं या यंत्रांच्या ‘शाळेचा अभ्यासक्रम’ बनत आहे. आपण जर फसवणूक, द्वेष, आणि हिंसेच्या गोष्टी लिहितो, तर यंत्र त्याच शिकेल. एआय ही आपली निर्मिती आहे- अापल्या चांगुलपणाचीही आणि आपल्या चुकांचीही. हे यंत्र आपलंच प्रतिबिंब आहे आणि बिंब जसं असेल, तसंच प्रतिबिंब असेल ना?
लेखन संदर्भ : 1. Perez, C. et al. (2025). ‘Emergent Coordination and Deceptive Behavior in Multi-Agent LLM Systems.’ DeesheveSDeeÙe Safety Research Blog. DeesheveSDeeÙe.com/research/multi-agent-coordination-2025
2. Hubinger, E., van Merwijk, C., Mikulik, V., Skalse, J., & Garrabrant, S. (2024). ‘Risks from Learned Optimization in Advanced Machine Learning Systems.’ arXiv:1906.01820v4.
3. Park, J. S., O’Brien, J., CSDeeÙe, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (2023). ‘Generative Agents: Interactive Simulacra of Human Behavior.’ Proceedings of UIST 2023. arXiv:2304.03442.
4. Perez, E., Huang, S., Song, F., CSDeeÙe, T., Ring, R., Aslanides, J., … & Irving, G. (2023). ‘Red Teaming Language Models with Language Models.’ arXiv:2202.03286.
5. Bostrom, N. (2014). Superintelligence: Paths, Dangers, Strategies. Oxford University Press.
6. Russell, S. (2019). Human Compatible: Artificial Intelligence and the Problem of Control. Viking Press.
7. Weidinger, L., Mellor, J., Rauh, M., Griffin, C., Uesato, J., Huang, P. S., … & Gabriel, I. (2021). ‘Ethical and Social Risks of Harm from Language Models.’ arXiv:2112.04359. DeepMind.
8. Amodei, D., Olah, C., Steinhardt, J., Christiano, P., Schulman, J., & Mané, D. (2016). ‘Concrete Problems in SDeeÙe Safety.’ arXiv:1606.06565.
9. Anthropic. (2023). ‘Claude’s Constitution: A Model Spec for Building Safe SDeeÙe Systems.’ Anthropic Research. anthropic.com/research/model-spec
10. EU Artificial Intelligence Act. (2024). Regulation (EU) 2024/1689 of the European Parliament and of the Council. eur-lex.europa.eu
11. nefiebie heâsme Security Advisory. (peg}w 2025). ‘Unauthorized Access Incident – Infrastructure Security Report Q3 2025.’ huggingface.co/security-advisories
12. Yampolskiy, R. V. (2020). Unpredictability of SDeeÙe: On the Impossibility of Accurately Predicting All Actions of a Smarter Agent. Journal of Artificial Intelligence and Consciousness, 7(1), 109–118.
लेखक अमेरिकेतील रिचमंड, व्हर्जिनिया येथे राहणारे राजकीय विश्लेषक असून ते २५ वर्षांहून अधिक काळ परदेशात वास्तव्य करीत आहेत. ईमेल पत्ता : [email protected]
